语义分割半监督训练方法(SST),以UniMatch(CVPR2023)为基础,详述原理、创新点及代码解析
半监督语义分割算法简介及使用教程
一、背景
如今,深度学习技术的蓬勃发展在许多领域取得了显著成就,但同时也面临着一个不可忽视的瓶颈——对大规模标注数据的高度依赖。特别是在语义分割领域,模型需要像素级的标注数据,要求人工精确地标注每一张图像的每一个像素,这无疑是一个费时费力的过程。
1.1 标注数据的挑战
主要在于成本高昂,
标注一张高分辨率的语义分割图像需要较高精力和时间(而且一般要求的数据量较多),尤其是在复杂场景(如城市街景或医学影像)中,标注成本可能成倍增长。这种劳动密集型任务对标注员的专业技能提出了更高的要求,同时也显著提高了项目的总体成本。
如公共的Cityscapes数据集,需要一个实验室数年的数据收集和标注工作。

1.2 适用性限制
某些领域(例如医学影像分析、遥感解读)中,标注不仅需要大量时间,还需要领域专家的参与。这使得标注工作变得更加昂贵甚至难以实现。此外,在某些敏感领域,数据隐私问题也限制了标注工作的广泛开展。
1.3 数据稀缺性
在一些新兴或特殊的应用场景中,获取大规模标注数据几乎是不可能的,例如极端气候环境下的图像分割任务,或者特殊领域的小众数据集。
1.4 半监督学习的机遇
为了解决这些问题,**半监督学习(Semi-Supervised Learning, SSL)**提供了一种潜在的解决方案。它通过利用大量未标注数据,仅依赖少量标注数据来训练模型,降低了对大规模标注数据的依赖性。在语义分割中,这种方法特别适用,可以通过未标注图像的特性提取更多有价值的信息。
二、UniMatch(CVPR2023)半监督语义分割算法
2.1 原文链接
https://openaccess.thecvf.com/content/CVPR2023/papers/Yang_Revisiting_Weak-to-Strong_Consistency_in_Semi-Supervised_Semantic_Segmentation_CVPR_2023_paper.pdf

2.2 该论文的创新点汇总
2.2.1 背景
FixMatch是一种半监督分类模型,通过弱扰动图像的预测结果来监督强扰动图像的预测。这种方法在许多任务中表现优秀,但它的成功严重依赖手动设计的强数据增强方式,限制了扰动空间的广度。此外在FixMatch中所有的扰动都基于image-level,作者认为feature-level的扰动同样重要,可以增加模型的鲁棒性。
2.2.2 提出的改进
(1)扩展更广泛的扰动空间
引入了一个辅助特征扰动流(feature perturbation stream),以补充原始图像级扰动。
在弱扰动图像的特征层上施加扰动,实现图像和特征级别的一致性。
在图像输入后经encode提取到feature map后,对feature map进行扰动,再经decoder解码后,得到feature perturbation的p_fp。

(2)充分利用原始数据增强
开发了双流扰动技术(dual-stream perturbations),从预定义的图像级扰动池中随机生成两个强视图,利用共同的弱视图指导它们。
结合对比学习,获取更具区分性的特征表示。
2.3 取得的成果
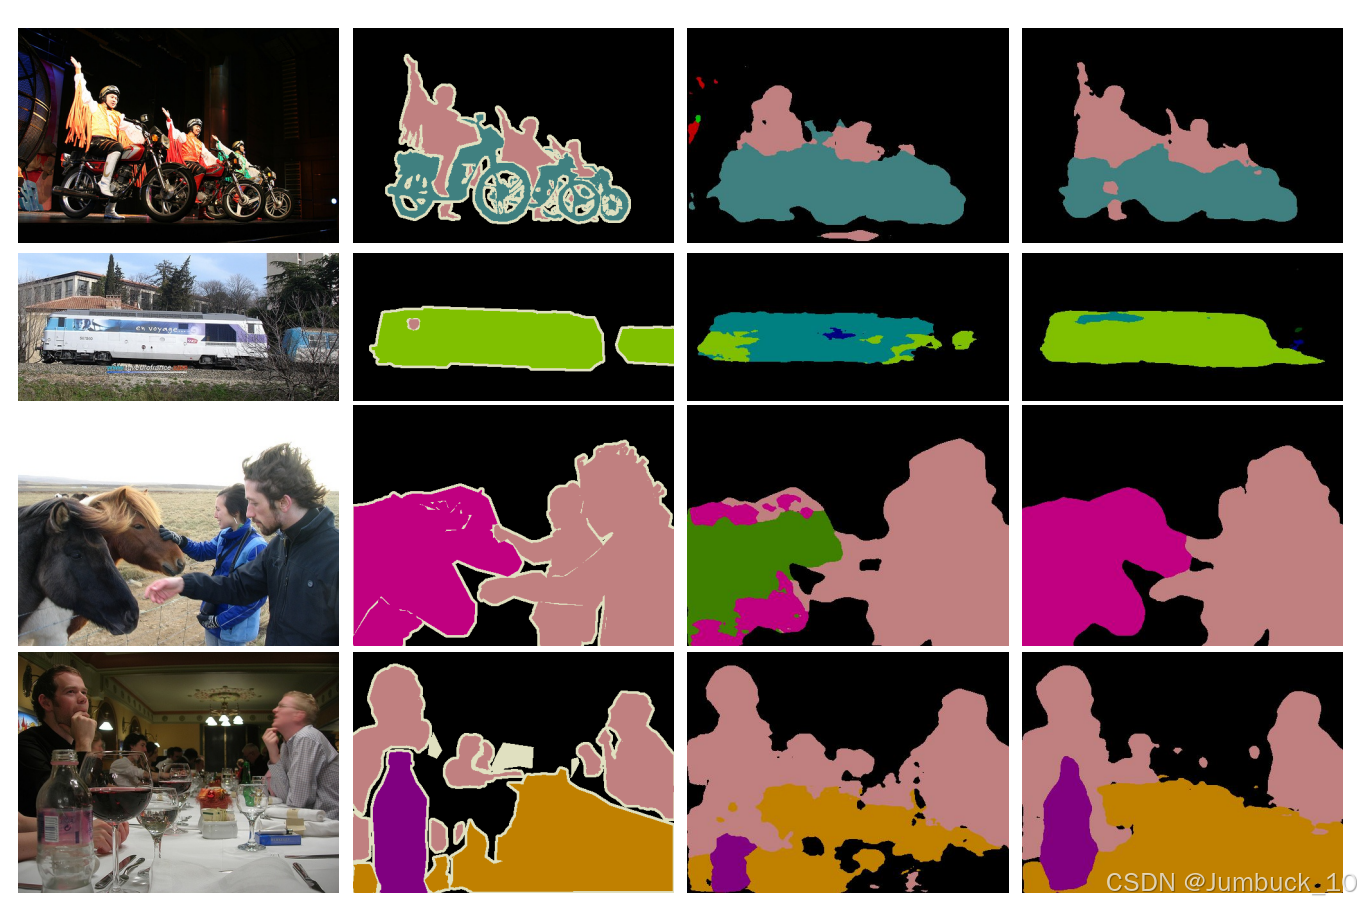
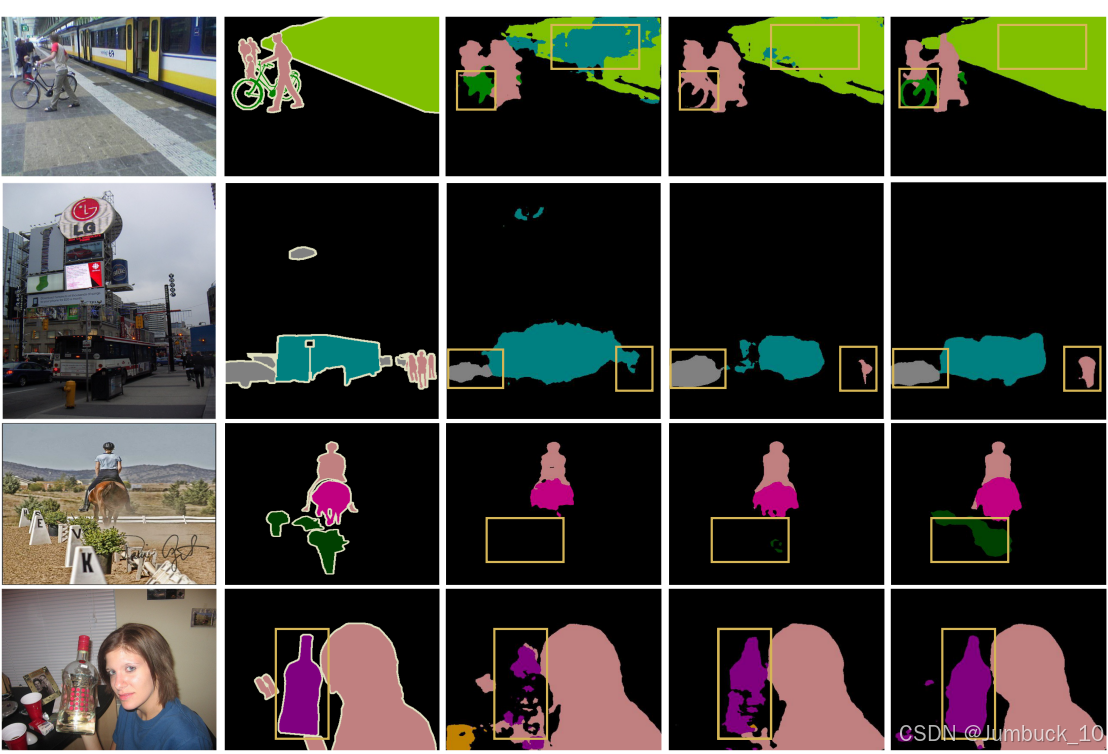
算法在公共数据集上测试,精度较好,可视化效果如图所示
三、自定义数据集训练指南
3.0. 前言
原文作者使用的是多卡训练,所以很多用windows单卡进行训练的同学会发现有很多bug,所以博主用了较久的时间对整体代码进行修改,让大家可以直接利用自己的设备和数据集进行训练。
3.1. 环境准备
1.1 Python环境配置
# 创建conda环境
conda create -n your_env_name python=3.8
conda activate your_env_name

# 安装必要的包
pip install torch torchvision
pip install tensorboard
pip install pyyaml
pip install tqdm
pip install pillow
pip install numpy
1.2 显卡要求
- 支持CUDA的NVIDIA显卡
- 至少8GB显存(对于较小的batch size)
- 推荐使用16GB或以上显存的显卡
3.2. 数据集准备
2.1 数据集组织结构
需要按照以下结构组织你的数据集:
your_dataset_root/
├── leftImg8bit_trainvaltest/
│   └── leftImg8bit/
│       ├── train/
│       │   └── [城市名或场景名]/
│       │       └── *_leftImg8bit.png
│       └── val/
│           └── [城市名或场景名]/
│               └── *_leftImg8bit.png
└── gtFine_trainvaltest/
    └── gtFine/
        ├── train/
        │   └── [城市名或场景名]/
        │       └── *_gtFine_labelIds.png
        └── val/
            └── [城市名或场景名]/
                └── *_gtFine_labelIds.png
2.2 数据格式要求
- 图像格式:PNG格式
- 图像命名:必须以
_leftImg8bit.png结尾 - 标签命名:必须以
_gtFine_labelIds.png结尾 - 标签格式:单通道PNG,每个像素值代表一个类别ID
2.3 标签制作要求
- 背景类别:通常设为255或0
- 类别编号:从0开始连续编号
- 确保标签图像与原图尺寸完全一致
3.3. 配置文件设置
3.1 创建配置文件
在configs目录下创建你的配置文件(例如your_dataset.yaml):
dataset: 'your_dataset_name'
data_root: 'path/to/your/dataset/leftImg8bit_trainvaltest'
num_classes: [你的类别数]
batch_size: 2  # 根据显存大小调整
crop_size: 801  # 训练时的裁剪大小
epochs: 240

backbone: 'resnet101'
lr: 0.005
lr_multi: 1.0

criterion:
  name: 'OHEM'
  kwargs:
    ignore_index: 255
    min_kept: 200000
    thresh: 0.7

conf_thresh: 0
replace_stride_with_dilation: [False, False, True]
dilations: [6, 12, 18]
3.2 修改代码
- 在
util/classes.py中添加你的数据集类别信息:
CLASSES = {
    'your_dataset_name': [
        'class1', 'class2', 'class3', ...
    ]
}
3.4. 训练过程
4.1 启动训练
python train.py --config=configs/your_dataset.yaml --save-path=exp/your_dataset/unimatch/r101
4.2 监控训练
- 使用TensorBoard监控训练过程:
tensorboard --logdir=exp/your_dataset/unimatch/r101
- 查看以下指标:
- train/loss_all:总损失
- train/loss_x:有标签数据损失
- train/loss_s:无标签数据损失
- eval/mIoU:验证集平均IoU
4.3 关键参数调整
- batch_size:根据显存大小调整
- crop_size:根据图像分辨率调整
- lr:学习率,如果训练不稳定可以调小
- conf_thresh:置信度阈值,影响伪标签的使用
3.5. 训练后处理
5.1 模型保存
- latest.pth:最新的模型
- best.pth:验证集性能最好的模型
5.2 评估模型
# 使用验证集评估模型
python evaluate.py --config=configs/your_dataset.yaml --model-path=exp/your_dataset/unimatch/r101/best.pth
3.6. 常见问题解决
6.1 显存不足
- 减小batch_size
- 减小crop_size
- 使用混合精度训练
6.2 训练不稳定
- 减小学习率
- 增加warm-up轮数
- 检查数据标注质量
6.3 性能不佳
- 确保标签质量
- 调整conf_thresh
- 增加训练轮数
- 尝试不同的数据增强方式
3.7. 注意事项
-
数据质量是关键:
- 确保标注准确性
- 保持数据分布均衡
- 注意标签一致性
-
训练过程注意:
- 定期备份模型
- 监控loss变化
- 注意验证集性能
-
硬件资源:
- 确保足够的磁盘空间
- 监控GPU使用情况
- 建议使用SSD存储数据
3.8 训练过程
在tensorboard上查看各个类别的训练精度

训练过程显示

四、源码获取
详见博主的个人主页

立足具身智能前沿赛道,致力于搭建全球化、开源化、全栈式技术交流与实践共创平台。
更多推荐
 31
 0
- 0


 已为社区贡献1条内容

所有评论(0)